Python · Guía práctica
Pandas: cómo leer y limpiar un archivo CSV paso a paso
Pandas es la librería estándar de Python para trabajar con datos tabulares. Este es el flujo básico para dejar un CSV listo para analizar.
Leer el archivo
import pandas as pd
df = pd.read_csv("ventas.csv", encoding="utf-8", sep=",")
print(df.head())
df.info()
Si ves caracteres extraños, prueba encoding="latin-1". Si el archivo usa punto y coma, cambia sep=";".
Detectar problemas
df.isna().sum()          # nulos por columna
df.duplicated().sum()    # filas duplicadas
Limpiar
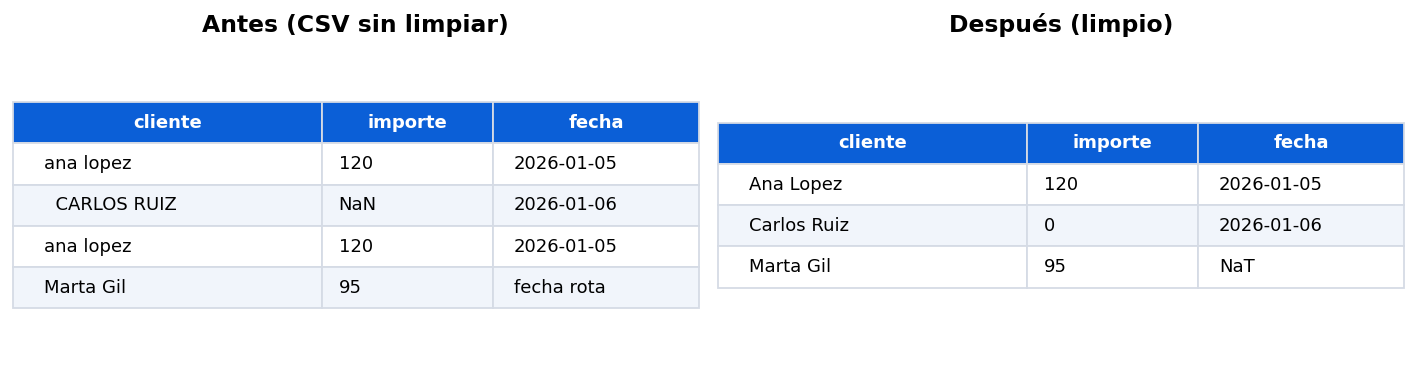
df = df.drop_duplicates()
df["importe"] = df["importe"].fillna(0)  # solo si ausencia significa cero
df["fecha"] = pd.to_datetime(df["fecha"], errors="coerce")
df["cliente"] = df["cliente"].str.strip().str.title()
Filtrar y resumir
df_2026 = df[df["fecha"].dt.year == 2026]
resumen = df_2026.groupby("cliente")["importe"].sum().sort_values(ascending=False)
Guardar el resultado
resumen.to_csv("resumen.csv")Revisa siempre los resultados con df.describe() para detectar valores atípicos antes de sacar conclusiones.
Separadores, decimales y valores ausentes
Los CSV no tienen un formato único. Un archivo exportado en español puede separar columnas con punto y coma y escribir decimales con coma. En ese caso prueba pd.read_csv("ventas.csv", sep=";", decimal=","). Si el archivo usa otra codificación, especifica la que realmente tenga; no cambies a latin-1 automáticamente, porque podrías ocultar caracteres mal leídos.
Revisa los nulos antes de sustituirlos. Rellenar un importe ausente con cero solo tiene sentido si el negocio define que ausencia como cero; a veces significa dato desconocido y conviene dejarlo vacío, corregirlo desde la fuente o excluirlo con una regla documentada. Compara recuentos antes y después:
print(df.isna().sum())
print(df.dtypes)
print(df.describe(include="all"))
Guardar sin perder información
Antes de exportar, valida fechas inválidas con errors="coerce" y cuenta cuántas quedaron como nulas. Escribe el resultado en otro archivo y conserva el original: así puedes repetir la transformación y comparar el número de filas, importes y claves antes y después.